

AI aģenti jau tiek izmantoti miljoniem organizāciju, un līdz ar to pieaug iespējas tos izmantot ļaunprātīgām darbībām — piemēram, datubāzu satura, konfidenciālas uzņēmumu informācijas vai personas datu izfiltrēšanai.
Pēdējo piecu mēnešu laikā Google un vēl četras organizācijas, kurām nav daudz kopīga, izņemot AI aģentu izmantošanu, ir atzinušas ievainojamības, kas ļauj vienam mērķa tīklā esošam aģentam izplatīt kaitīgas instrukcijas citiem iekšējiem aģentiem. Tā ir īpaša promptu injekcijas forma: uzbrukums nav vērsts tieši pret lielo valodas modeli, bet gan pret konkrētu aģentu, piemēram, tulkošanas vai datu analīzes rīku.
Šādu specializētu aģentu aizsardzības mehānismi bieži ir vāji vai to nav vispār. Aģents saņem uzbrucēja sagatavotu tekstu, nodod to nākamajam aģentam kā parastu deleģētu uzdevumu, bet otrais aģents instrukciju izpilda, jo uzticas tam, kurš uzdevumu nosūtījis.
MCP uzticēšanās ķēde
Neatkarīgais pētnieks Syed Anas Mohiuddin pārbaudīja aģentus organizācijās, tostarp Google, JP Morgan Chase, Weviate, Rapid7, Francijas valdības starpministriju digitālajā direktorātā un ASV federālajā valdībā. Viņa koncepcijas pierādījuma uzbrukumi izmanto uzticēšanās trūkumus MCP jeb Model Context Protocol.
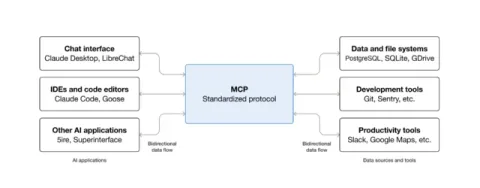
MCP ir standarts, kas ļauj AI lietotnēm un aģentiem sazināties iekšējā tīklā. Daudzi specializētie aģenti nepiedāvā aizsardzību, kas parasti mazinātu promptu injekcijas bīstamākās sekas. Turklāt MCP serveros tiek glabāti katra aģenta piekļuves dati, bet aģenti pēc noklusējuma veidoti tā, lai uzticētos citiem iekšējiem aģentiem.
Tāpēc uzbrukums, ko lielais valodas modelis būtu noraidījis, var izdoties, ja tas tiek nodots caur pareizi izvēlētu aģentu. Daudzos gadījumos rūpīgi izveidoti uzvedņu teksti var izraisīt servera puses pieprasījumu viltošanu jeb SSRF — ievainojamību, kas ļauj tīmekļa serverim veikt neatļautus pieprasījumus tīklā.
“AI aģenti uzbrucējiem dod jaunu savienojumu kopumu, pa kuru pārvietoties,” izdevumam Ars sacīja Rapid7 ievainojamību izlūkošanas direktors Duglass Makī. “Kāds ievieto tekstu saturā, aģents to nolasa un nodod citam aģentam kā parastu deleģētu uzdevumu, bet otrais aģents to izpilda, jo uzticas tam, kurš uzdevumu nodeva.”
Makī norādīja, ka katrs ķēdes posms šādā situācijā izdara tieši to, kam paredzēts. Tas uzbrukumu padara grūti pamanāmu: katrs protokols ir izveidots ar pieņēmumu, ka darbojas patstāvīgi, tāpēc pārbauda savu “ieejas durvju” drošību, kamēr neviens neuzrauga koridoru starp protokoliem.
No zemas bīstamības līdz kritiskākai ievainojamībai
Rapid7 tīklā atklātā ievainojamība CVE-2026-97228 saņēma tikai 2,7 punktus no 10 pēc bīstamības skalas. Rapid7 to novērsa pagājušajā mēnesī.
Google skartā ievainojamība bija nopietnāka — tās vērtējums sasniedza 8 punktus. Problēma bija saistīta ar datubāzēm paredzēto MCP rīkkopu googleapis/mcp-toolbox. Tā inicializēja HTTP klientu, neizmantojot CheckRedirect politiku — iestatījumu kopumu, kas nosaka servera rīcību gadījumā, ja URL atgriež kļūdu vai novirza uz citu adresi.
Google HTTP klients arī nepārbaudīja mērķa IP adreses. “Izveidots ceļa parametrs varēja piespiest rīkkopu sekot novirzei uz iekšēju galapunktu un uzbrucēja vārdā nosūtīt pieprasījumus,” skaidroja Mohiuddins.
Google labojums paredzēja atļauto IP adrešu diapazonu sarakstu un bloķēšanas sarakstus. Nedrošs bāzes URL tagad tiek noraidīts, jau programmai startējot, nevis tikai pirmā pieprasījuma laikā. Pēc pētnieka teiktā, tas ir pienācīgs SSRF aizsardzības piemērs, lai gan šādu pārbaudi lielākā daļa MCP serveru vēl nav ieviesusi.
“Protokolu pivotēšana” vai promptu injekcija?
Mohiuddins uzbrukumu klasi dēvē par “protokolu pivotēšanu”, jo tajā lietotne vai serveris izmanto MCP, lai uzdotu aģentam uzdevumu, bet aģents pēc tam pārsūta kaitīgās instrukcijas citam aģentam, kas saziņai izmanto citu metodi. Viens piemērs ir Google Agent-to-Agent jeb A2A protokols, kas paredzēts aģentu savstarpējai deleģēšanai; tiek minēti arī tādi topoši standarti kā Agent Network Protocol.
Pēc pētnieka domām, šādā pārsūtīšanā uzticēšanās vai autorizācija bieži tiek faktiski pazaudēta. Viņš “protokolu pivotēšanu” aprakstīja kā daudzpakāpju uzbrukumu, kurā uzbrucējs sākotnējo piekļuvi iegūst caur vienu protokolu, izmanto starp protokoliem pastāvošus uzticēšanās pieņēmumus un piekļūst iespējām, kas pieejamas tikai caur citu protokolu.
Tomēr Markus Vervjē no X41 D-Sec, kurš arī izstrādājis AI uzbrukumus, kas izmanto MCP, uzskata, ka precīzāks apzīmējums joprojām ir promptu injekcija un ka Mohiuddina aprakstītā metode ir tikai tās vienkāršs paveids.
“Manuprāt, tā ir netieša promptu injekcija,” viņš sacīja. “Tas, ka kaitīgais prompts var nākt no cita protokola, piemēram, A2A, un izpausties, kad tiek izmantots cits protokols, nav obligāta prasība, lai šādi uzbrukumi darbotos. Taču tas, protams, ir negaidīti un kopumā grūti novēršams.”
Drošības pamatprincipi nav piemēroti
Uzbrukuma paņēmiens darbojās piecās organizācijās, kurām vienīgā būtiskā kopīgā iezīme bija MCP izmantošana. Tas ir nozīmīgi, jo MCP ir salīdzinoši jauns, tomēr jau kļuvis plaši izplatīts, pirms tas pietiekami pārbaudīts un nostiprināts.
Organizācijām steidzoties veidot sarežģītas aģentu arhitektūras, tās ir atstājušas novārtā drošības principu “nulles uzticēšanās” jeb zero trust. Šajā modelī tīkls tiek veidots, pieņemot, ka viens vai vairāki tā mezgli var būt inficēti. Lai mazinātu sekas, katram mezglam pirms sensitīvu darbību veikšanas ar citu mezglu jāpieprasa autorizācija.
“Galvenā atziņa, ko es gribētu, lai cilvēki paņem līdzi, ir šāda: viss, kas no LLM nonāk jūsu rīkā, jāuztver kā ievade no svešinieka internetā, jo promptu injekcijas scenārijā tieši tā arī ir,” sacīja Makī. Viņš piebilda, ka pamatā esošās problēmas — injekcija un SSRF — ir sen zināmas, bet to novēršanas principi 20 gadu laikā nav mainījušies. Pētnieks esot pelnījis atzinību par uzbrukuma nosaukšanu, jo nosaukums palīdz aizsargiem un standartu izstrādātājiem tam mērķtiecīgi veidot aizsardzību.
 Tehnoloģijas
 Tehnoloģijas
 Tehnoloģijas